ML-KEMで用いる法3329上のNTT演算
← 技術
CANDARW 2026 原稿
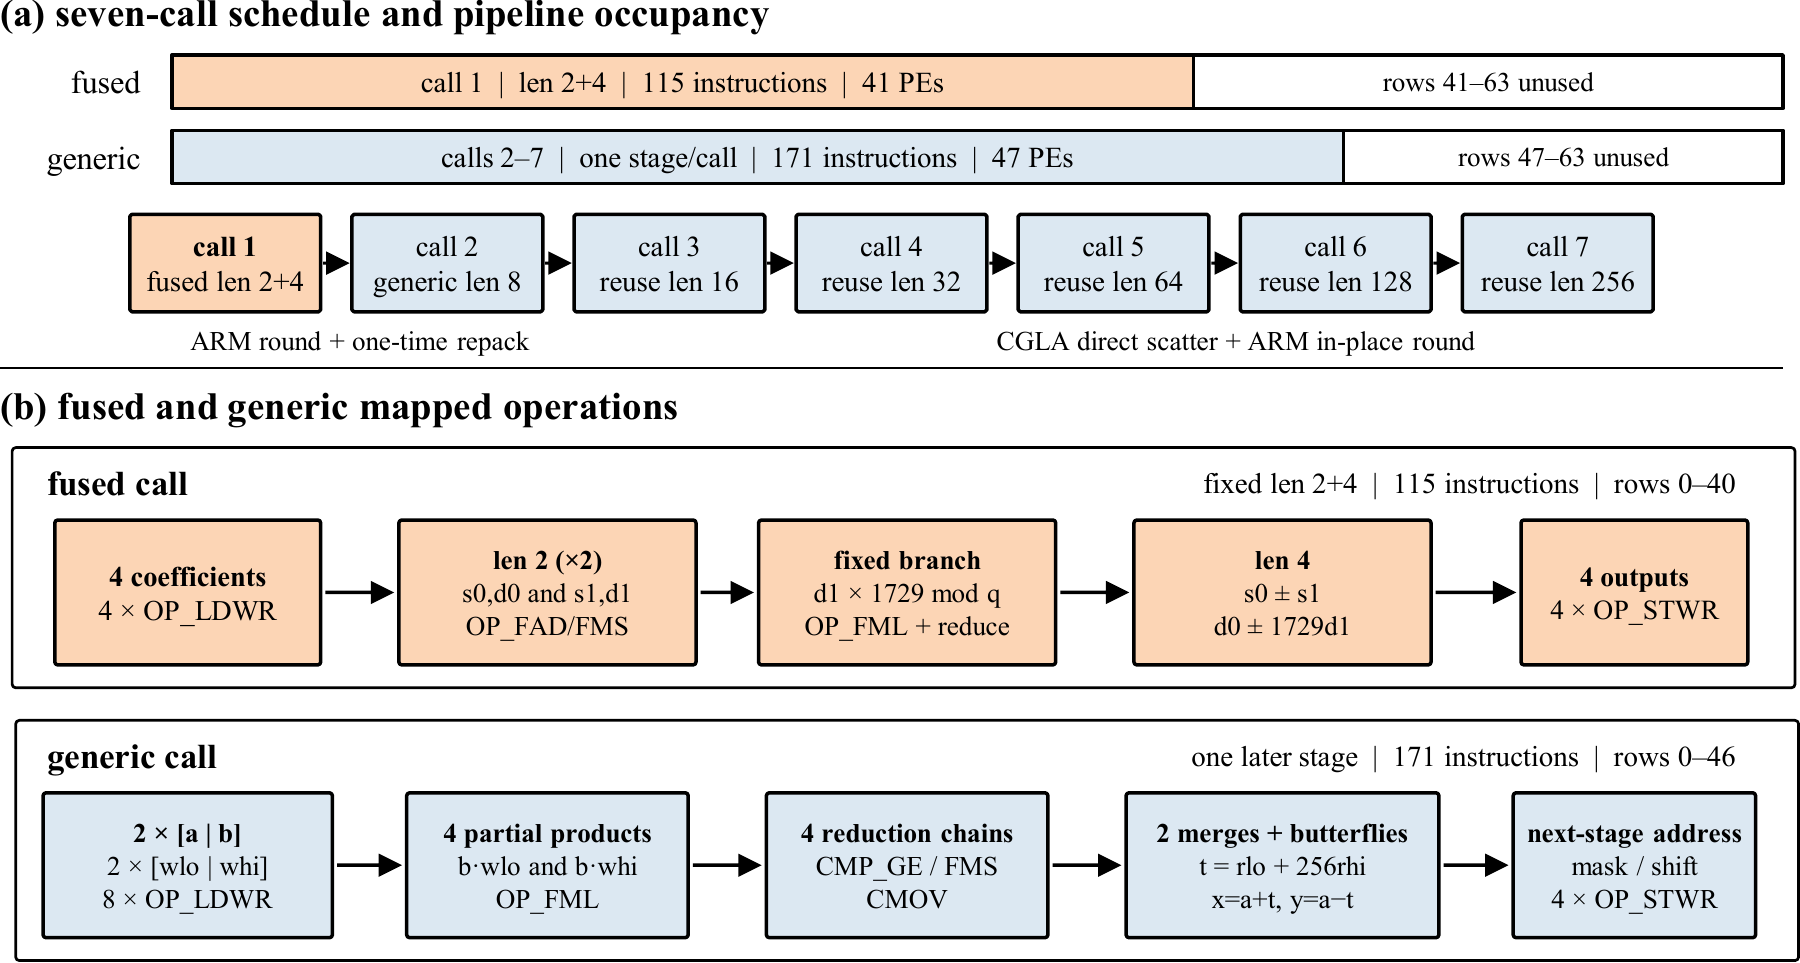
NTTの演算分解と41/47-PE 割当て(arXiv公開版)。 出典
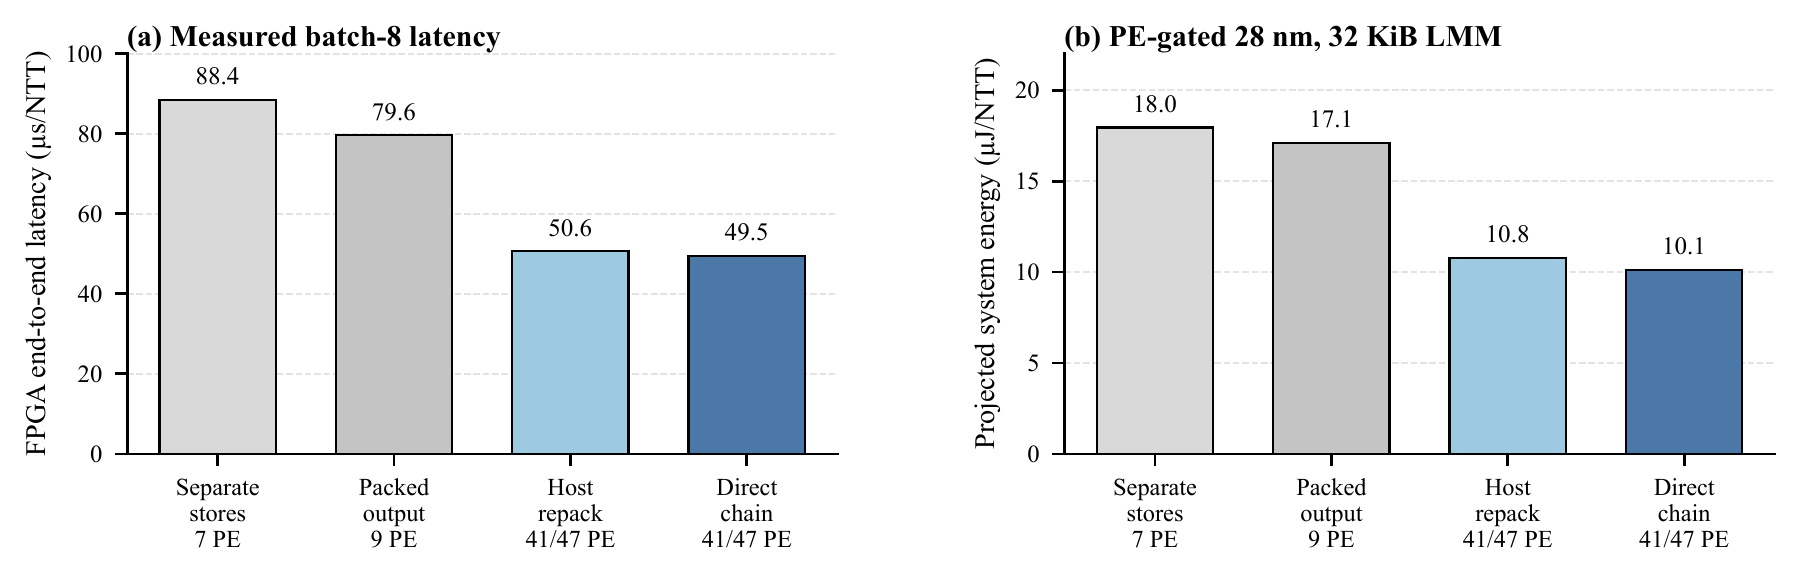
バッチ 8でのオフロード深度比較。FPGA実測時間と、PEの動作制御を含むASIC システム全体のエネルギーの投影(arXiv公開版)。 出典
ML-KEMで使われる法q=3329の演算を、既存のCGLAのデータパスへ載せる研究です。専用NTTユニットを追加する代わりに、演算の分解と段間レコードの配置をソフトウェアで構成しています。
手法と評価条件の詳細は、 論文(arXiv公開版) にまとめています。
実装・評価した内容
- 回転因子を8ビットと4ビットに分割し、部分積を剰余へ落としてから再結合するFP32によるバタフライ演算を構成。
- 先頭2段を41-PE呼出しへ融合し、残りを47-PE呼出しで処理する7回の呼出しを連結する処理を実装。
- 各段の出力を次段向けレコードへ直接格納し、ARM側の並べ替えと正規化、DMAを含む処理境界を評価。
- CPU参照との係数比較、バッチ条件ごとの実測、ASIC投影を原稿に整理。
結果
原稿では4組の実験条件・105回のFPGA実行で817,152出力係数がCPU参照と一致しています。
バッチサイズ64で測定したFPGA上の処理全体の時間は27.5 µs/NTTです。これはASIC実測値ではありません。