← 技術
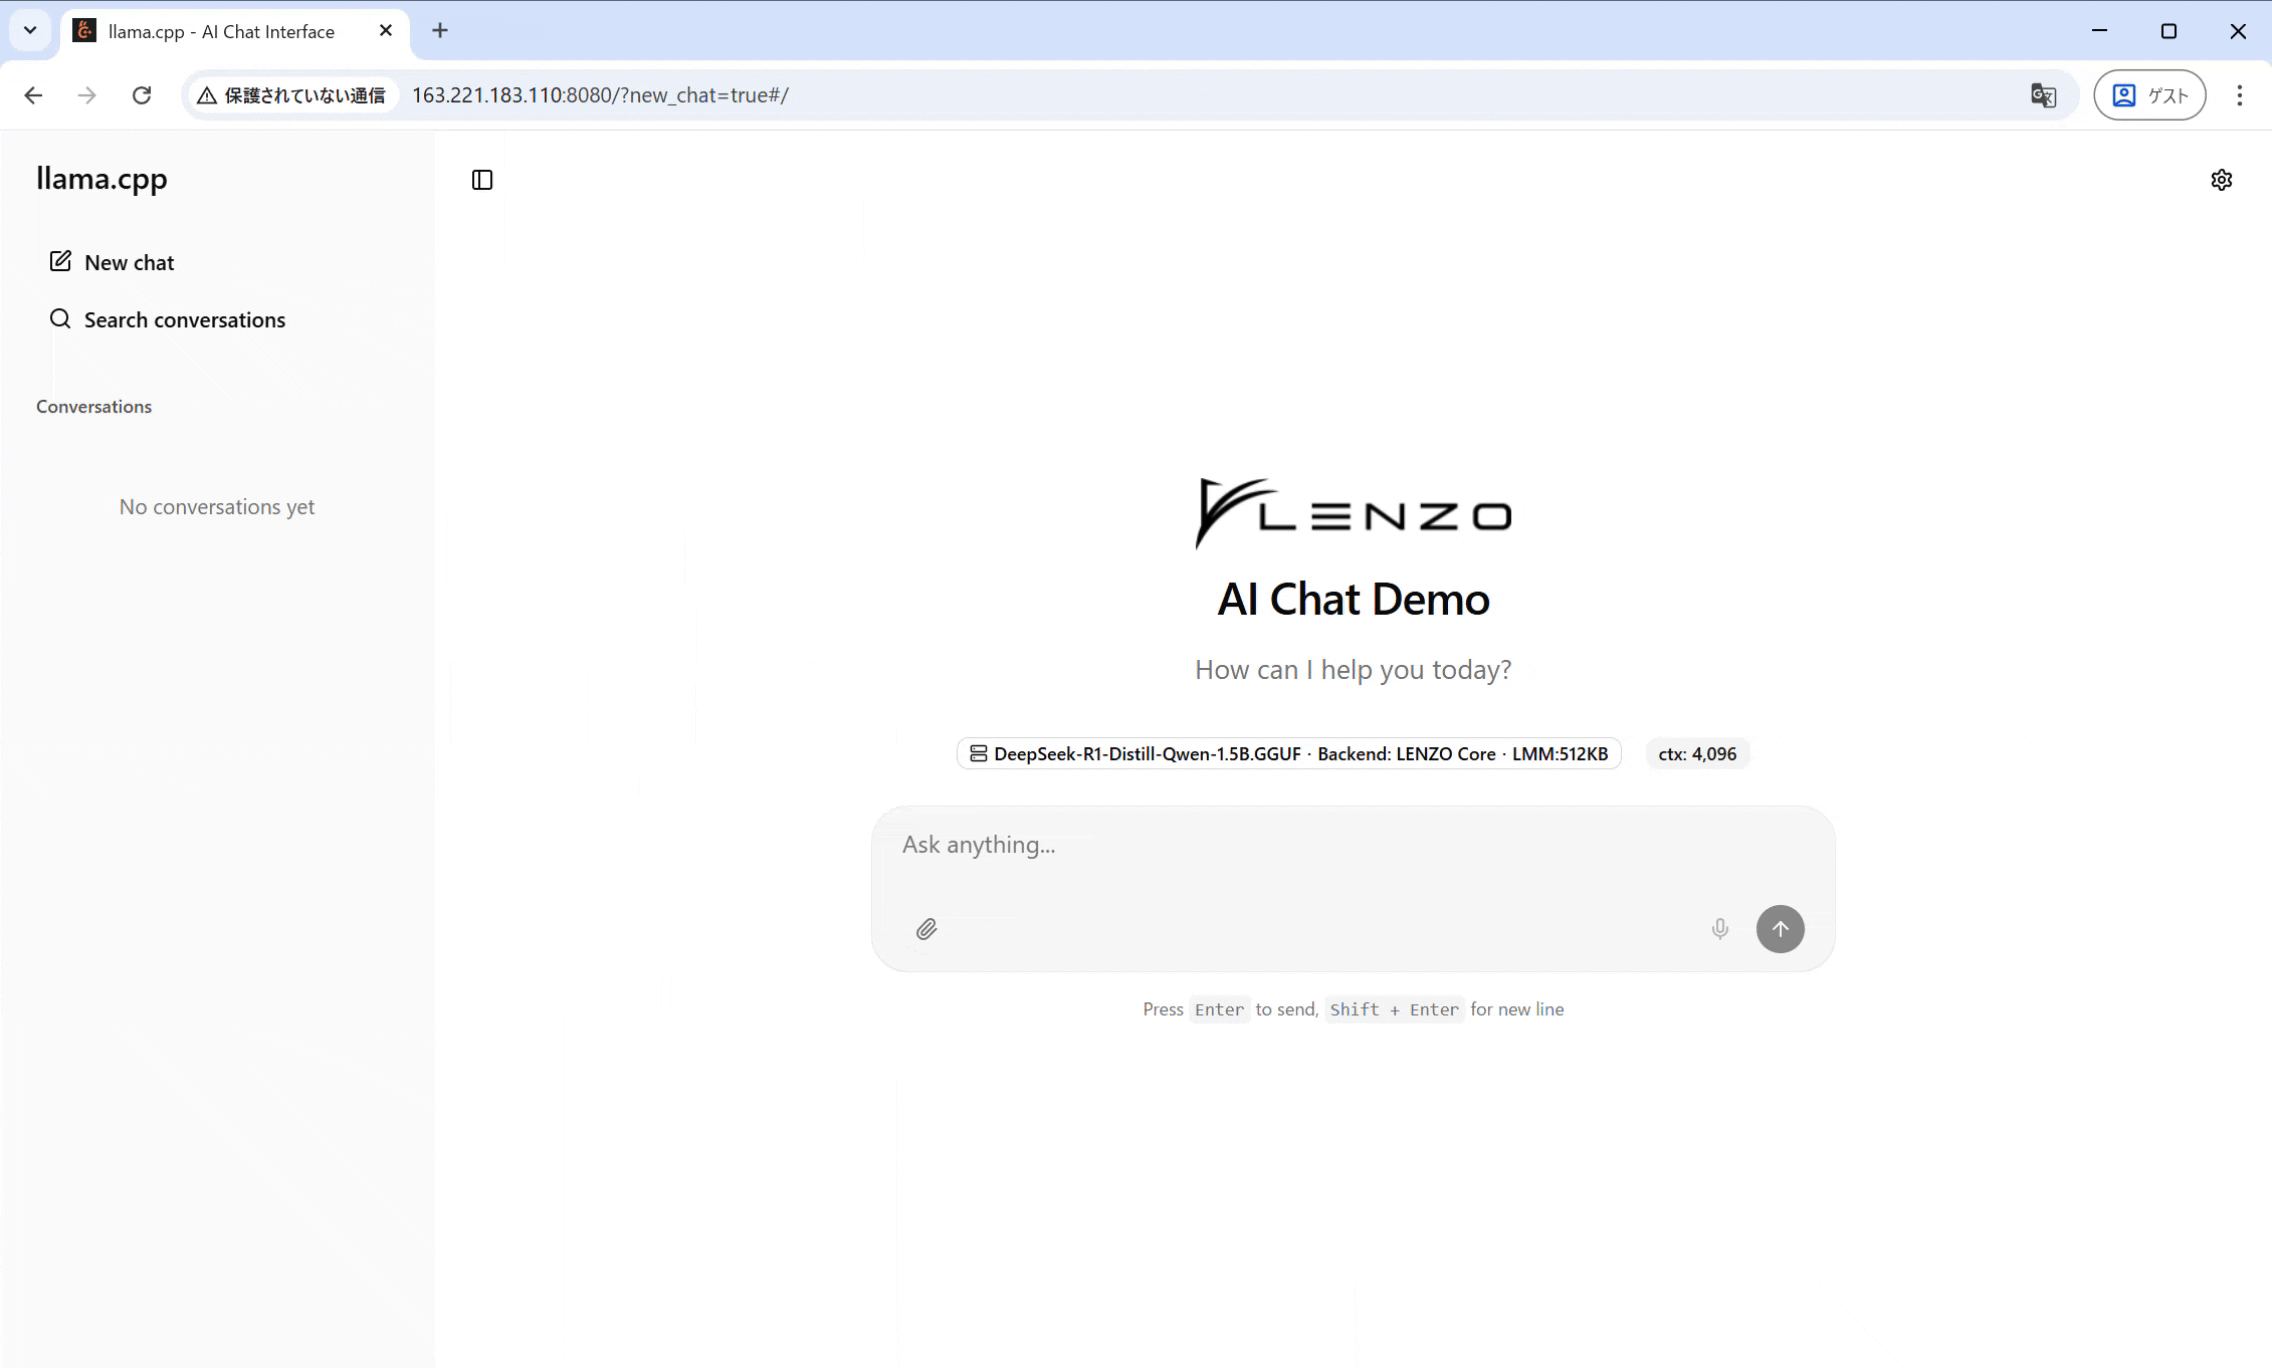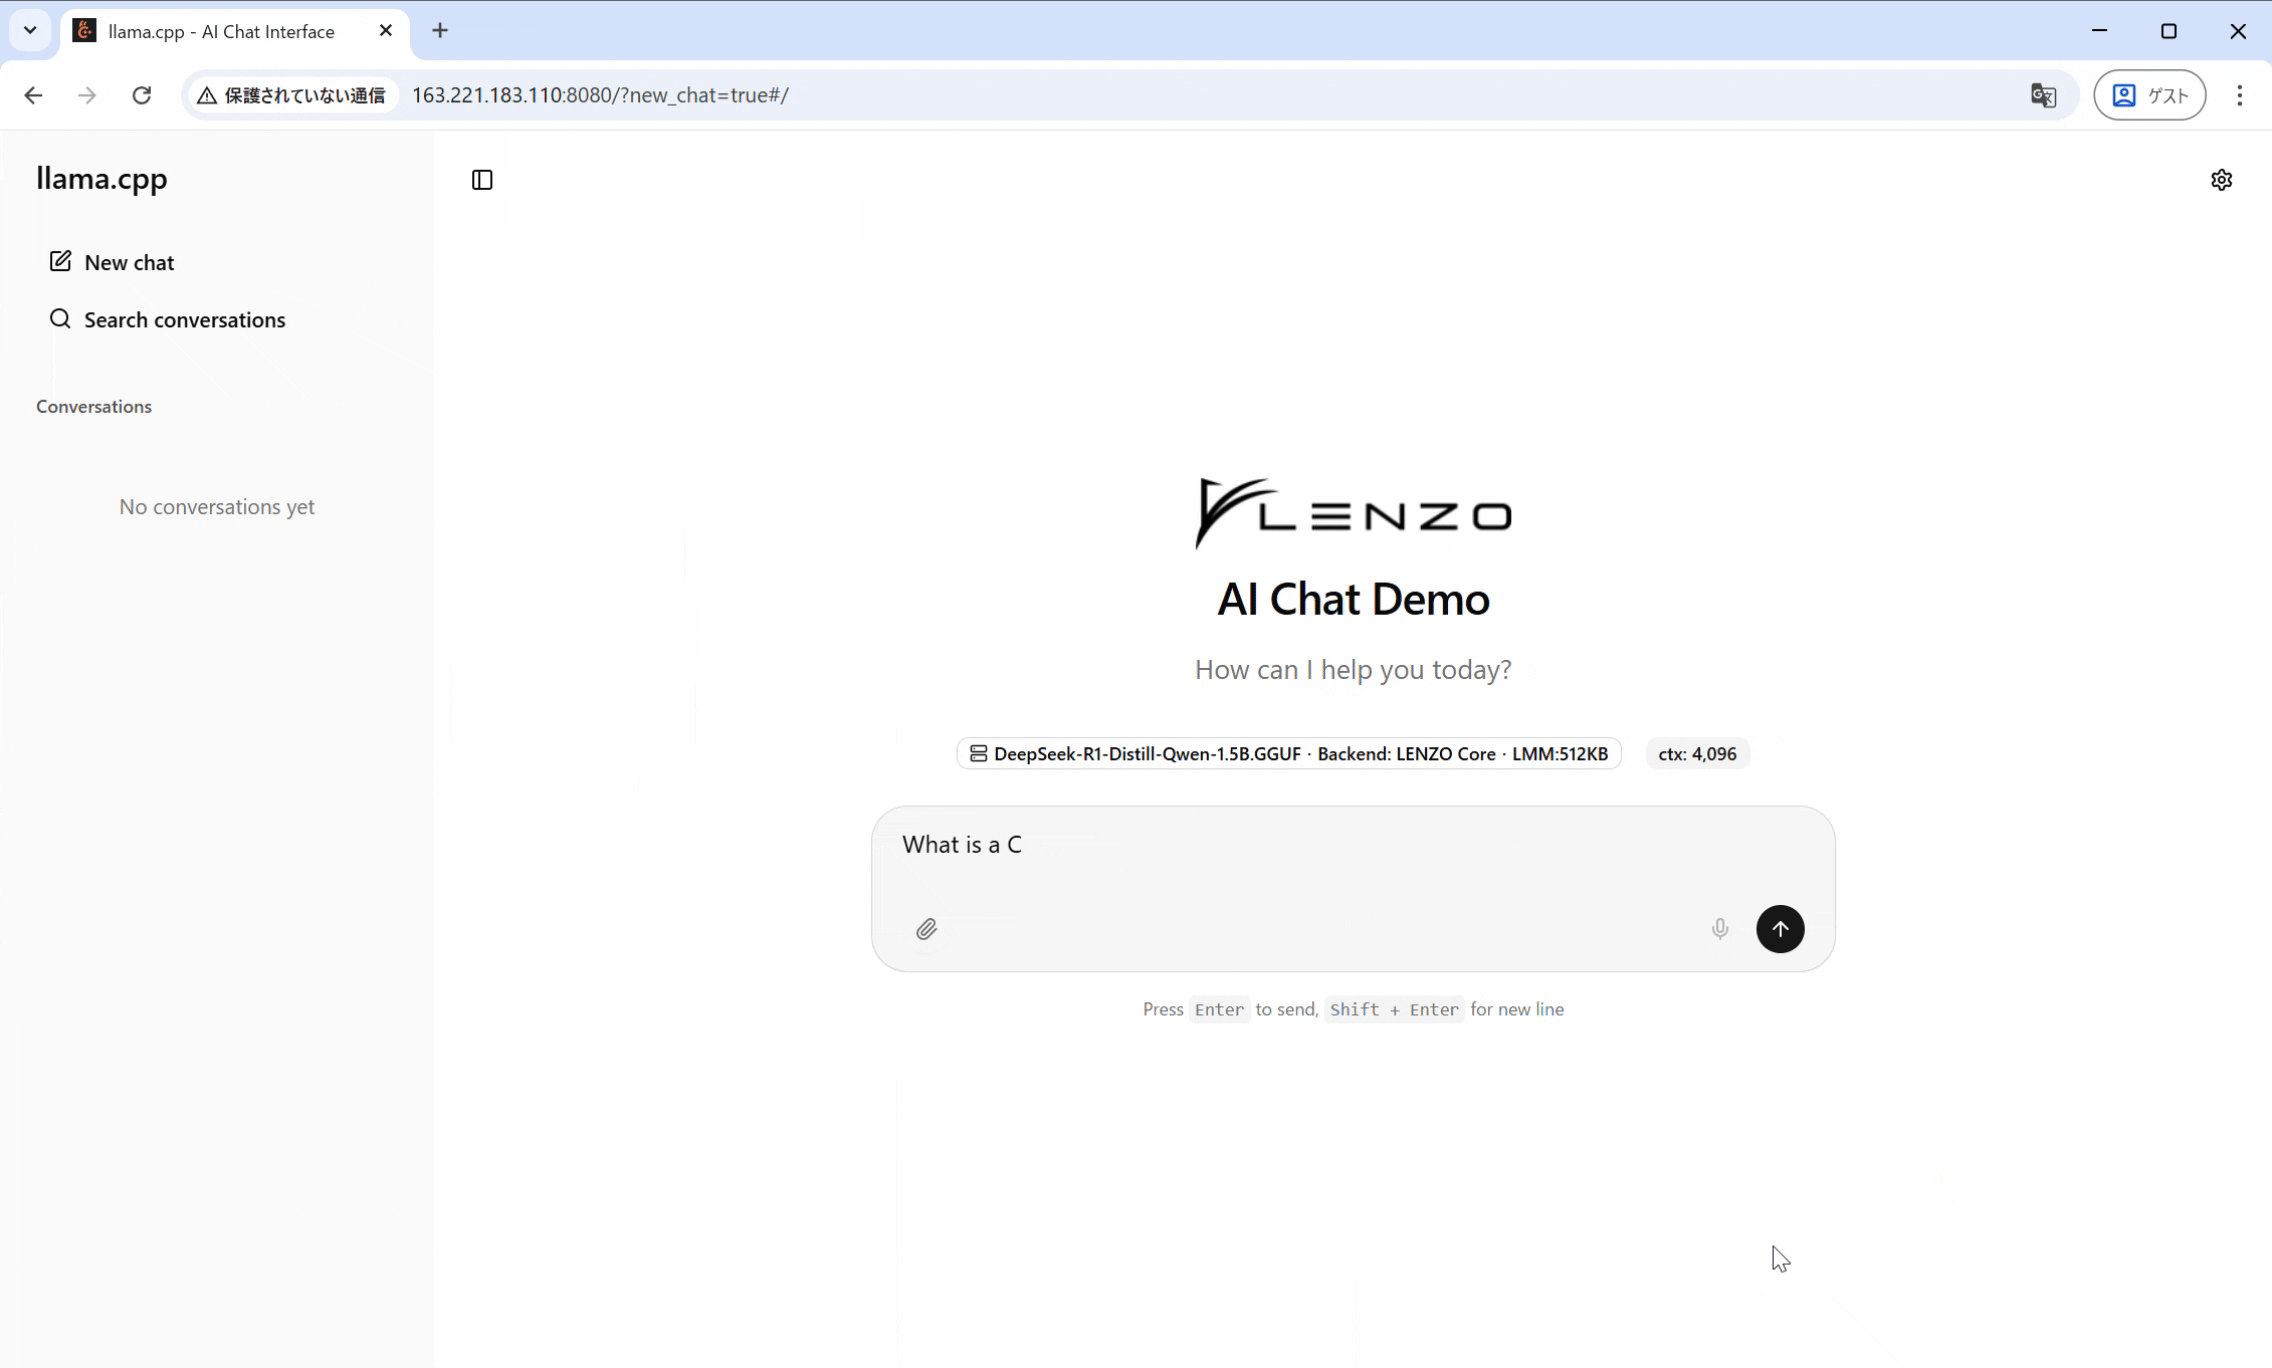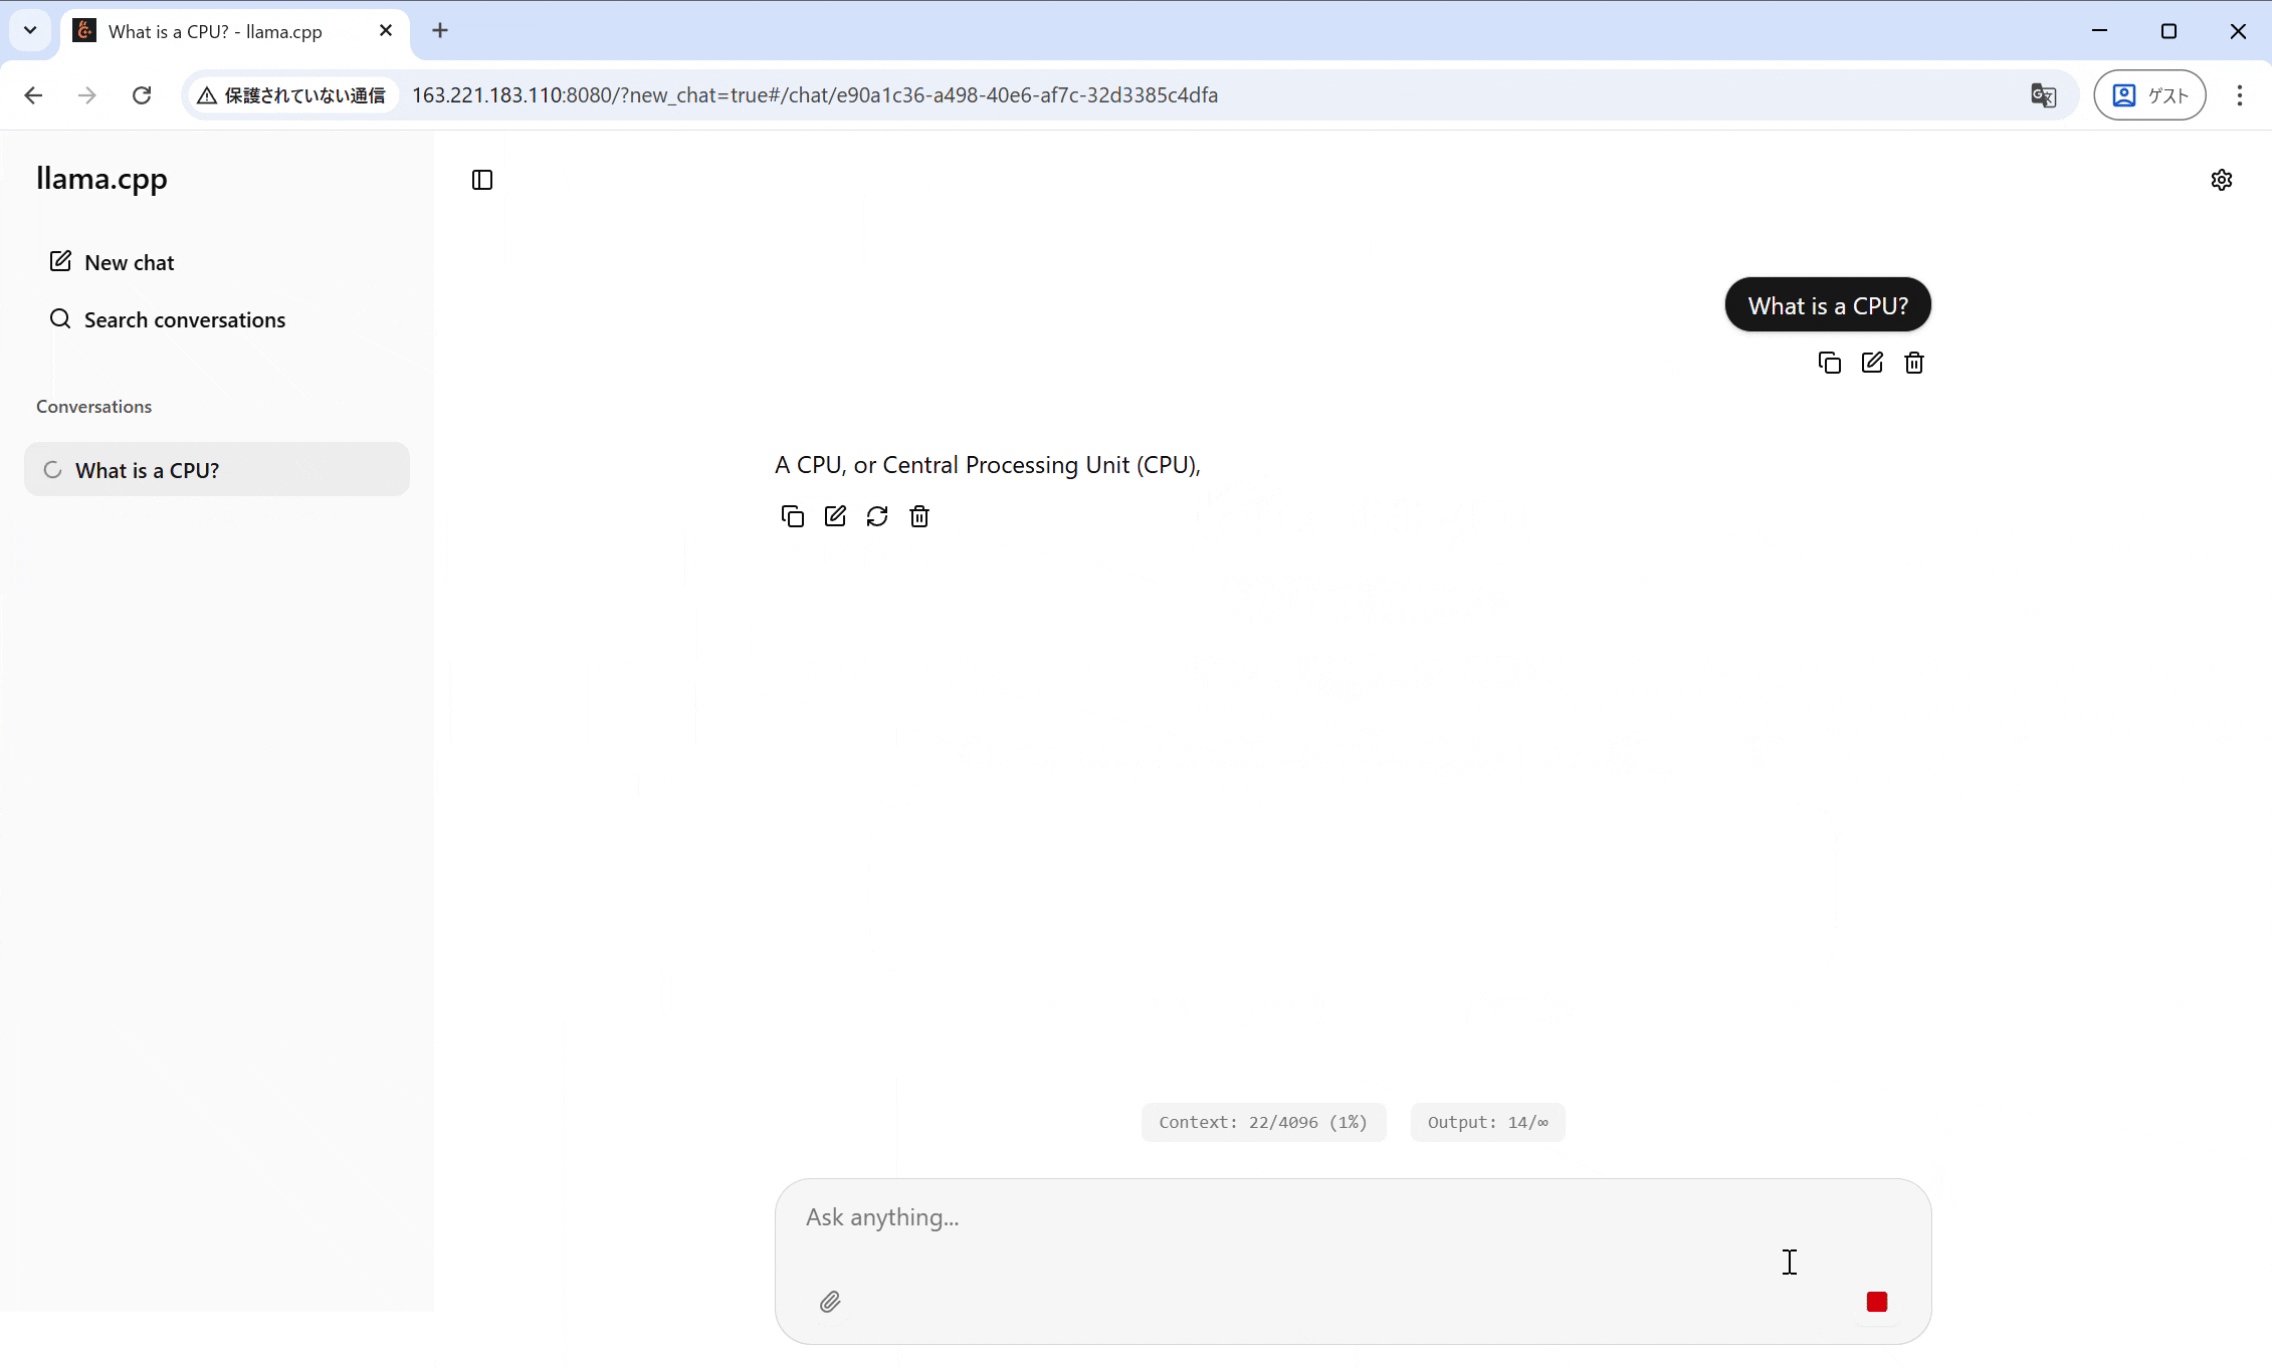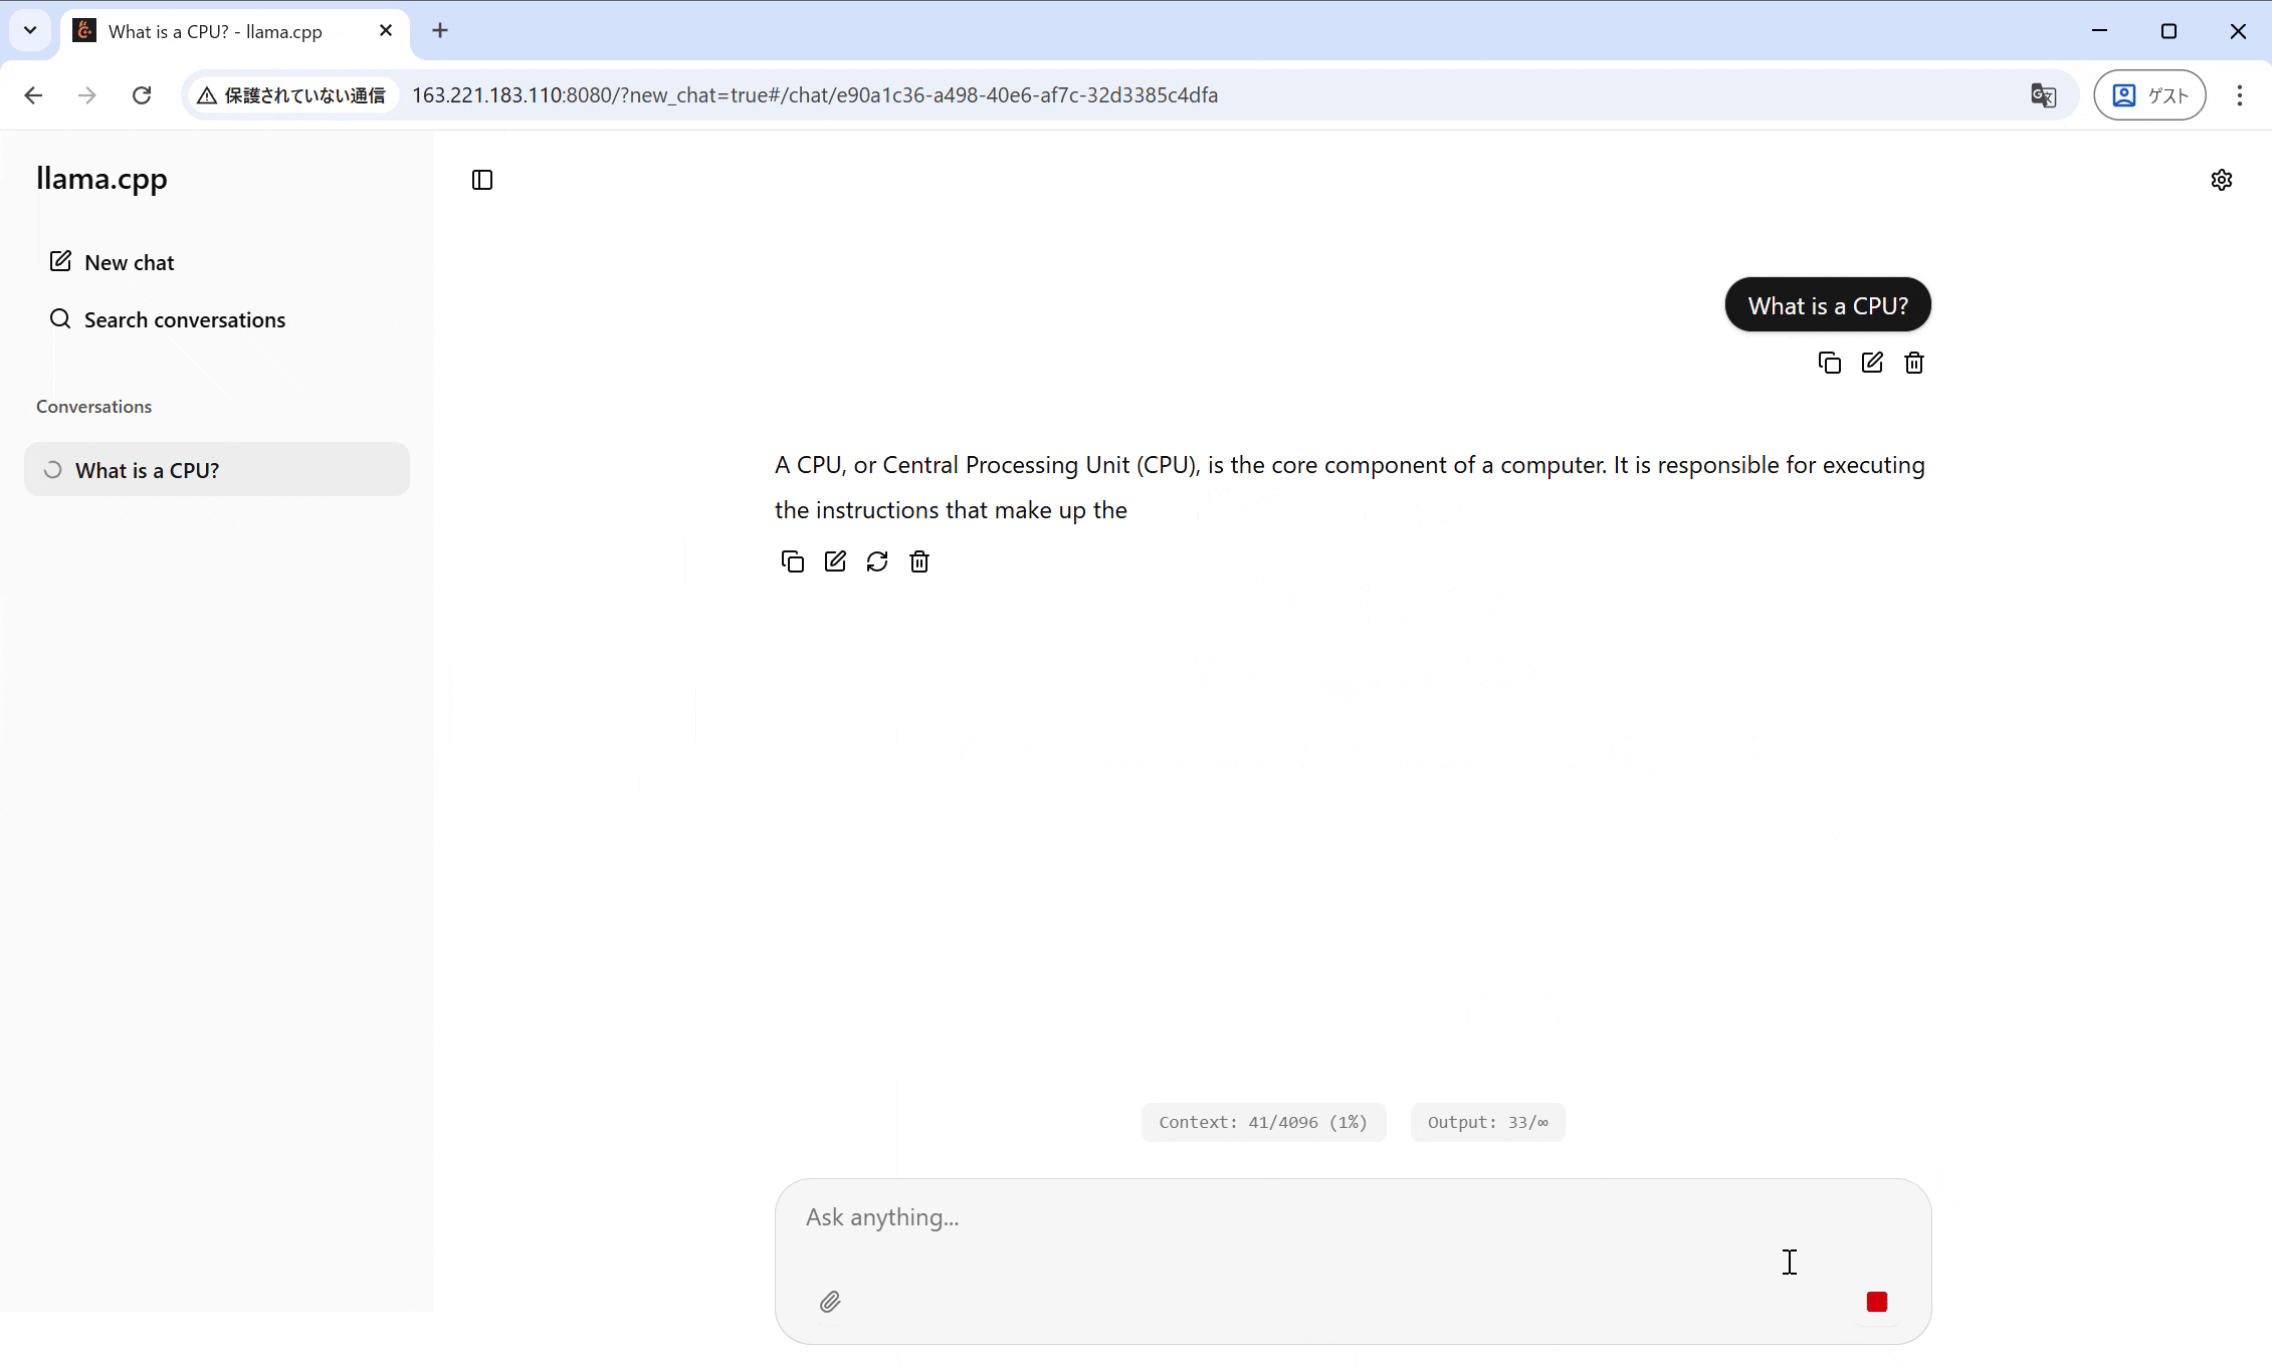
既存サイトのLLMチャット動作デモ。性能測定ログではありません。
CGLA向けLLM実行最適化
ICISN 2026量子化LLMをCGLAで実行する際のチャンク分割を扱った研究です。量子化アライメントと実行時のメモリ制約に応じてチャンクサイズを選び、プリフィルの転送オーバーヘッドを評価しました。
実装・評価した内容
- 固定チャンク分割で生じるホスト・デバイス間転送のオーバーヘッドを分析。
- 量子化条件とメモリ制約に応じてチャンクサイズを動的に選択する手法を実装。
- 同じIMAX環境で従来手法とQ-snapのプリフィルのスループットを比較。
結果
既存原稿ではプリフィルのスループットを17.11 トークン/秒から27.70 トークン/秒へ改善し、1.62倍の高速化を報告しています。
動作デモはLLM実行環境の紹介です。スループットの測定ログとは区別します。